파이썬을 설치한다?
일종의 번역팩을 설치한다고 생각하면 됩니다. 컴퓨터는 101010001 과 같은 언어만 알아듣는다고 했지요? 파이썬 문법으로 된 것을 101010001로 변환해줄 수 있도록, 번역 패키지를 설치하는 것입니다.
1) 변수 & 기본연산
a = 3 # 3을 a에 넣는다
b = a # a를 b에 넣는다
a = a + 1 # a+1을 다시 a에 넣는다
num1 = a*b # a*b의 값을 num1이라는 변수에 넣는다
num2 = 99 # 99의 값을 num2이라는 변수에 넣는다
# 변수의 이름은 마음대로 지을 수 있음!
변수 추가 = .append()
2) 자료형
숫자, 문자형
name = 'bob' # 변수에는 문자열이 들어갈 수도 있고,
num = 12 # 숫자가 들어갈 수도 있고,

is_number = True # True 또는 False -> "Boolean"형이 들어갈 수도 있습니다.

#########
# 그리고 List, Dictionary 도 들어갈 수도 있죠. 그게 뭔지는 아래에서!
리스트 형 (Javascript의 배열형과 동일)
a_list = []
a_list.append(1)     # 리스트에 값을 넣는다
a_list.append([2,3]) # 리스트에 [2,3]이라는 리스트를 다시 넣는다

# a_list의 값은? [1,[2,3]]
# a_list[0]의 값은? 1
# a_list[1]의 값은? [2,3]
# a_list[1][0]의 값은? 2
Dictionary 형 (Javascript의 dictionary형과 동일)
a_dict = {}
a_dict = {'name':'bob','age':21}
a_dict['height'] = 178

# a_dict의 값은? {'name':'bob','age':21, 'height':178}
# a_dict['name']의 값은? 'bob'
# a_dict['age']의 값은? 21
# a_dict['height']의 값은? 178
Dictionary 형과 List형의 조합
people = [{'name':'bob','age':20},{'name':'carry','age':38}]

# people[0]['name']의 값은? 'bob'
# people[1]['name']의 값은? 'carry'

person = {'name':'john','age':7}
people.append(person)

# people의 값은? [{'name':'bob','age':20},{'name':'carry','age':38},{'name':'john','age':7}]
# people[2]['name']의 값은? 'john'
3) 함수 - 이름은 마음대로 정할 수 있다.
let 대신 def가 들어간다. ;대신 :를 사용한다. 중괄호가 없음.
# 수학문제에서
f(x) = 2*x+3
y = f(2)
y의 값은? 7

# 참고: 자바스크립트에서는
function f(x) {
	return 2*x+3
}

# 파이썬에서
def f(x):
	return 2*x+3

y = f(2)
y의 값은? 7
함수의 응용
def sum_all(a,b,c):
	return a+b+c

def mul(a,b):
	return a*b

result = sum_all(1,2,3) + mul(10,10)

# result라는 변수의 값은?
조건문
if / else 로 구성
tab(들여쓰기)으로 안의 내용물을 구분한다.
def oddeven(num):  # oddeven이라는 이름의 함수를 정의한다. num을 변수로 받는다.
	if num % 2 == 0: # num을 2로 나눈 나머지가 0이면
		 return True   # True (참)을 반환한다.
	else:            # 아니면,
		 return False  # False (거짓)을 반환한다.

result = oddeven(20)
# result의 값은 무엇일까요?
예시
def is_adult(age):
	if age > 20:
		print('성인입니다')    # 조건이 참이면 성인입니다를 출력
	else:
		print('청소년이에요')  # 조건이 거짓이면 청소년이에요를 출력

is_adult(30)
# 무엇이 출력될까요?
반복문
리스트와 함께 쓰도록 기획됨. 리스트의 요소들을 하나씩 꺼내서 내용물해서 쓴다.
fruits = ['사과','배','감','귤']

for fruit in fruits:
	print(fruit)

# 사과, 배, 감, 귤 하나씩 꺼내어 찍힙니다.
def count_fruits(target):
count = 0
for fruit in fruits:
if fruit == target:
count += 1
return count
subak_count = count_fruits('수박')
print(subak_count) #수박의 갯수
gam_count = count_fruits('감')
print(gam_count) #감의 갯수딕셔너리 예제
people = [{'name': 'bob', 'age': 20},
          {'name': 'carry', 'age': 38},
          {'name': 'john', 'age': 7},
          {'name': 'smith', 'age': 17},
          {'name': 'ben', 'age': 27}]

# 모든 사람의 이름과 나이를 출력해봅시다.
for person in people:
    print(person['name'], person['age'])


# 이번엔, 반복문과 조건문을 응용한 함수를 만들어봅시다.
# 이름을 받으면, age를 리턴해주는 함수
def get_age(myname):
    for person in people:
        if person['name'] == myname:
            return person['age']
    return '해당하는 이름이 없습니다'


print(get_age('bob'))
print(get_age('kay'))
DB개괄
DB에는 Index 라는 순서로 데이터들이 정렬되어 있다.
DB의 두 가지 종류
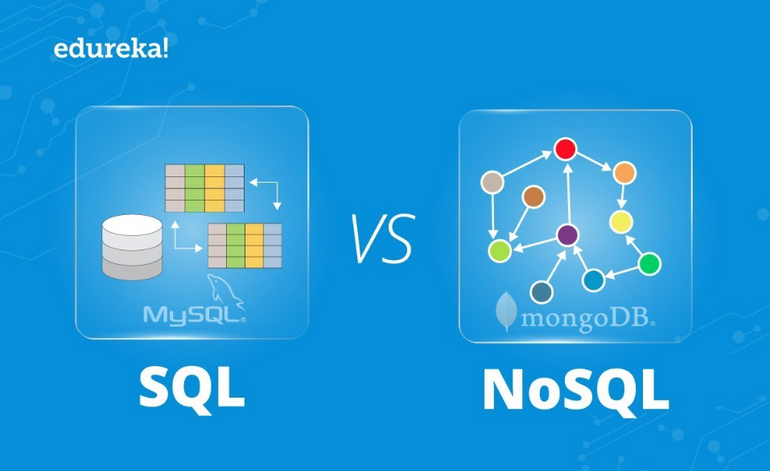
RDBMS(SQL) : 행/열의 생김새가 정해진 엑셀에 데이터를 저장하는 것과 유사합니다. 데이터 50만 개가 적재된 상태에서, 갑자기 중간에 열을 하나 더하기는 어려울 것입니다. 그러나, 정형화되어 있는 만큼, 데이터의 일관성이나 / 분석에 용이할 수 있습니다. ex) MS-SQL, My-SQL 등
No-SQL : 딕셔너리 형태로 데이터를 저장해두는 DB입니다. 고로 데이터 하나 하나 마다 같은 값들을 가질 필요가 없게 됩니다. 자유로운 형태의 데이터 적재에 유리한 대신, 일관성이 부족할 수 있습니다. ex) MongoDB
pymongo 기본 코드
from pymongo import MongoClient
client = MongoClient('여기에 URL 입력')
db = client.dbsparta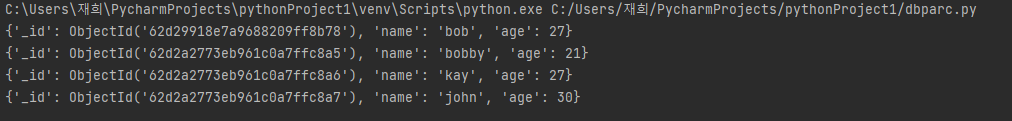
# 모든 데이터 뽑아보기
all_users = list(db.users.find({},{'_id':False}))

print(all_users[0])         # 0번째 결과값을 보기
print(all_users[0]['name']) # 0번째 결과값의 'name'을 보기

for user in all_users:      # 반복문을 돌며 모든 결과값을 보기
    print(user)
불필요한 _id 출력을 제어하기 위한 코드
all_users = list(db.users.find({},{'_id':False}))# 저장 - 예시
doc = {'name':'bobby','age':21}
db.users.insert_one(doc)
# 한 개 찾기 - 예시
user = db.users.find_one({'name':'bobby'})
# 여러개 찾기 - 예시 ( _id 값은 제외하고 출력)
all_users = list(db.users.find({},{'_id':False}))
# 바꾸기 - 예시
db.users.update_one({'name':'bobby'},{'$set':{'age':19}})
# 지우기 - 예시
db.users.delete_one({'name':'bobby'})pymongo 기본 세팅
import requests
from bs4 import BeautifulSoup

from pymongo import MongoClient
client = MongoClient('mongodb+srv://test:sparta@cluster0.55vah.mongodb.net/Cluster0?retryWrites=true&w=majority')
db = client.dbsparta

# URL을 읽어서 HTML를 받아오고,
headers = {'User-Agent' : 'Mozilla/5.0 (Windows NT 10.0; Win64; x64)AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36'}
data = requests.get('https://movie.naver.com/movie/sdb/rank/rmovie.naver?sel=pnt&date=20210829',headers=headers)

# HTML을 BeautifulSoup이라는 라이브러리를 활용해 검색하기 용이한 상태로 만듦
soup = BeautifulSoup(data.text, 'html.parser')

# select를 이용해서, tr들을 불러오기
movies = soup.select('#old_content > table > tbody > tr')

# movies (tr들) 의 반복문을 돌리기
for movie in movies:
    # movie 안에 a 가 있으면,
    a_tag = movie.select_one('td.title > div > a')
    if a_tag is not None:
        rank = movie.select_one('td:nth-child(1) > img')['alt'] # img 태그의 alt 속성값을 가져오기
        title = a_tag.text                                      # a 태그 사이의 텍스트를 가져오기
        star = movie.select_one('td.point').text                # td 태그 사이의 텍스트를 가져오기
print(rank,title,star)'언어공부-프론드엔드 > Python' 카테고리의 다른 글
| vscode로 가상환경 패키지를 설치시 일어난 문제 해결 (0) | 2022.10.28 |
|---|
