pep : 파이썬의 기본적인 포맷팅 규칙이다. 좀 더 정갈하게 보이기 위해 알려주는 규칙.
※알고리즘의 파이썬 쓰는 이유 :List Comprehention구글링 해보기
알고리즘에서 먼저 생각해야하는 이유 : 인지부화를 줄이기위해.코딩테스트를 할 때도 알고리즘처럼 생각하면 좋다.
익숙하지 않은 말을 한글보다 영어로 먼저 써야하기때문에 어색할 수 있다.
각 숫자마다 비교하여 최댓값 구하기
for문을 2번 쓰는 이유 : 첫번째 인덱스로 가지고 있는 값과 다음 값을 비교하기 위해서
대조구는 하나만 고정하는 것.그리고 그 나머지 숫자를 비교하기 위해 이중for문을 쓴다.
쉽게 말해서 첫번째 포문은 배열 중 첫번째(3)를 고정시켜서 두번째 포문으로 input에 있는 나머지 숫자와 비교한다.
num = 고정대상
compare_num = 나머지 비교 숫자
for문의 코드가 실행이 끝나면 else를 실행한다.
input = [3, 5, 6, 1, 2, 4]


def find_max_num(array):
    for num in array:
        for compare_num in array: //이중반복문. num과 compare의 배열을 반복한다.
            if num < compare_num: //num이 compare보다 작아면 break실행. 대조문.
                break
        else: //for문이 끝날때까지 break가 걸리지 않았다면 실행한다.
            return num //한번도 if문에 걸리지 않으면 num을 반환한다.


result = find_max_num(input)
print(result)
지정변수를 이용한 최대값 구하기
input = [3, 5, 6, 1, 2, 4]

def find_max_num(array):
    max_num = array[0] //배열의 임의의 숫자를 비교할 것이기 때문에 초기값을 설정해주는것.
    for num in array:
        if num > max_num:
            max_num = num
    return max_num


result = find_max_num(input)
print(result)
파이썬에서 문자인지 확인하는 방법
함수 str.isalpha() 를 사용한다. 입력값에 스페이스바나 숫자가 있을 때 사용하면 좋다.
print("a".isalpha())    # True
print("1".isalpha())    # False

s = "abcdefg"
print(s[0].isalpha())   # True
알파벳 별로 빈도수를 리스트에 저장하기
1. 알파벳 별 빈도수를 저장하기 위한 길이가 26인 0으로 초기화된 배열을 만든다.
alphabet_occurrence_array = [0] * 26 //초기화된 배열 생성 코드
2. 배열의 각 원소에 알파벳마다 빈도수를 추가한다.
ex) a일 경우 0번째 원소에 1을 추가한다.
0이 26개 있다는 것은 0번째 원소인 a는 0번째 인덱스에 빈도수에 저장된다.
그럼 이어지는 첫번째 인덱스에는 b의 빈도수가 저장된다. 이때 이 순서에 대한 것을 컴퓨터에게 알려줘야하는데
이 때 사용하는것이 바로 아스키 코드다.
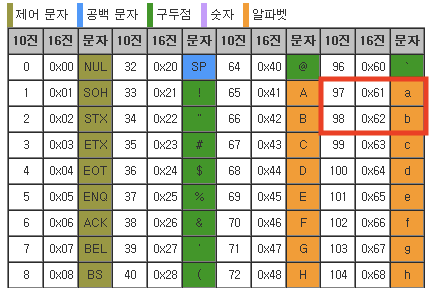
왜 아스키 코드를 사용해야 하는가.
컴퓨터는 0과 1 숫자 밖에 모르기 때문에 문자도 숫자로 기억한다.
그래서 아스키 코드로
문자→숫자로, 숫자 →문자로 변환이 가능하다.
아스키 코드표(ASCII Table) (tistory.com)
링크로 좀 더 자세한 코드를 볼 수 있다.
위에 사진을 보면 a가 97 ,b가 96인걸 확인할 수 있다.
"python char to ascii code"을 구글링 해서 코드 사용법에 대해 알 수있다.
내장 함수 ord() 이용해서 아스키 값을 받을 수 있다. ord에서 a의 값을 빼면 0이된다.
이 값은 a의 인덱스 값이 0임을 알려주는 변환 코드이다.
print(ord('a'))               # 97
print(ord('a') - ord('a'))    # 97-97 -> 0
print(ord('b') - ord('a'))    # 98-97 -> 1
def find_alphabet_occurrence_array(string):
alphabet_occurrence_array = [0] * 26
# 아무런 조작도 하지 않았기 때문에 실행시 0이 26개가 출력된다.
# 이런식의 배열을 비트맵 자료구조라 한다. 특정index의 카운팅을 돌린다.
for char in string: # string 은 알파벳이 몇개인지 알아야하는 문장.
if not char.isalpha():
continue #이것으로 알파벳인지 구분 가능.
arr_index = ord(char) - ord("a") #char(97) - a(1)으로 char의인덱스값을 확인할 수 있다.
alphabet_occurrence_array[arr_index] += 1
return alphabet_occurrence_array
#if not은 아닌것을 거른다. ==false보다 간단해서 사용한다.
print(find_alphabet_occurrence_array("hello my name is sparta"))최빈값을 찾기
각 알파벳마다 문자열을 돌면서 몇 글자 나왔는지 확인합니다. 만약 그 숫자가 저장한 알파벳 빈도 수보다 크다면, 그 값을 저장하고 제일 큰 알파벳으로 저장합니다.
input = "hello my name is sparta"


def find_max_occurred_alphabet(string):
    alphabet_arr = ["a", "b", "c", "d", "e", "f", "g", "h", "i", "j", "k", "l", "m", "n", "o", "p", "q", "r", "s",
                      "t", "u", "v", "x", "y", "z"]
    # input에 있는 알파벳들을 다 비교해줘야하기 때문에 arr를 정해준것이다.
    max_occ = 0
    max_alphabet = alphabet_arr[0]

    for alphabet in alphabet_arr:
        occ = 0
        for char in string: #문자열에 있는 문자와 동일하다면 occ를 하나씩 추가해준다.
            if char == alphabet:
                occ += 1
        if occ < max_occ:
            max_occ = occ
            max_alphabet = alphabet
    return max_alphabet


result = find_max_occurred_alphabet(input)
print(result)
시간복잡도
입력값과 문제를 해결하는 데 걸리는 시간과의 상관관계
ex)입력값이 두배로 늘어난다면 문제를 해결하는데 걸리는 시간은 몇배로 늘어나는가로 보는 관계
입력값
함수에서 크기가 변경될 수 있는 값
배열을 받고 있으니 이 함수에서는 배열이 입력값
보통 입력값의 길이는 N이라고 표현한다.
왜 N을 사용하느냐하면 시간복잡도의 경우 N 의 크기에 따른 시간의 상관관계를 계산 하는 것이라 수식으로 표현하는 것이 옳다.
위의 최대값구하기첫번째 방법의 경우 각 줄이 실행되는 걸 1번의 연산이 된다는것을 토대로 시간을 측정할 수 있다.
array가 길이의 변화가 있을 수 있으니 1줄 array(6) x 2줄 array(6)으로 생각하면 될 것같다.
array의 길이 X array의 길이 X 비교 연산 1번 = N X N = N^2만큼의 시간이 걸린다.
    for num in array:              # array 의 길이만큼 아래 연산이 실행
        for compare_num in array:  # array 의 길이만큼 아래 연산이 실행
            if num < compare_num:  # 비교 연산 1번 실행
                break
        else:
            return num
위의 최대값구하기 두번째의 경우
1. max_num 대입 연산 1번
2. array의 길이 X (비교 연산 1번 + 대입 연산 1번) = 2N+1의 시간이 걸린다.
    max_num = array[0] # 연산 1번 실행
	for num in array:      # array 의 길이만큼 아래 연산이 실행
	if num > max_num:  # 비교 연산 1번 실행
	max_num = num  # 대입 연산 1번 실행
N 의 길이가 길어질수록, 연산량이 변화한다.
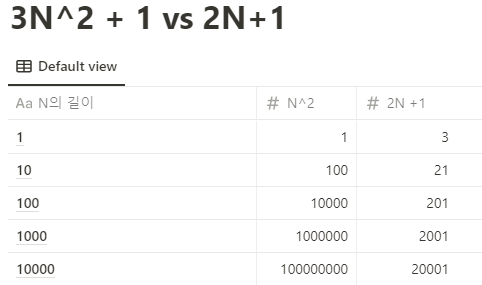
1. N 과 N^2 은 N 이 커질수록 더 큰 차이가 난다. 이를 통해 N^2이 비효율적인걸 확인가능하다.
2. N의 지수를 먼저 비교하고, 시간복잡도를 분석하면 된다.
- 매 번 이런식으로 연산을 하는 것은 사실상 불가능하다. 따라서 상수는 신경쓰지말고, 입력값에 비례해서 어느 정도로 증가하는지만 파악하는 것이 좋다.
즉,2N+1의 연산량이 나온 첫번째 풀이 방법은N만큼의 연산량이 필요하다
N^2의 연산량이 나온 두번째 풀이 방법은N^2만큼의 연산량이 필요하다. 참고로, 만약 상수의 연산량이 필요하다면,
1만큼의 연산량이 필요하다고 말하면 됩니다.
위의 최빈값 구하기의 두번째 예시로
string 의 길이는 보통 N이라고 표현한다.
1. alphabet_array 의 길이 X 대입 연산 1번 = 26
2. alphabet_array 의 길이 X string의 길이 X (비교 연산 1번 + 대입 연산 1번) = 52N
3. alphabet_array 의 길이 X (비교 연산 1번 + 대입 연산 2번) = 78
= 26*(1 + 2*N + 3) = 52N + 104
그러나 상수는 필요하지 않으므로 N의 시간만 필요하다고 할 수 있다.
	for alphabet in alphabet_array:    # alphabet_array 의 길이(26)만큼 아래 연산이 실행
		occurrence = 0                  # 대입 연산 1번 실행
		for char in string:             # string 의 길이만큼 아래 연산이 실행
			if char == alphabet:        # 비교 연산 1번 실행
			occurrence += 1         # 대입 연산 1번 실행

		if occurrence > max_occurrence: # 비교 연산 1번 실행
			max_alphabet = alphabet     # 대입 연산 1번 실행
			 max_occurrence = number     # 대입 연산 1번 실행
위의 최빈값 첫번째 예시로
- string의 길이 X (비교 연산 1번 + 대입 연산 2번)
- 대입 연산 2번
- alphabet_array 의 길이 X (비교 연산 1번 + 대입 연산 3번)
= N * (1 + 2) + 2 + 26 * (1 + 3) = 3N + 106
string 의 길이는 보통 N이라고 표현합니다.
그러나 상수는 필요하지 않으므로 N의 시간만 필요하다고 할 수 있다.
    for char in string:        # string 의 길이만큼 아래 연산이 실행
        if not char.isalpha(): # 비교 연산 1번 실행
            continue
        arr_index = ord(char) - ord('a')         # 대입 연산 1번 실행
        alphabet_occurrence_list[arr_index] += 1 # 대입 연산 1번 실행

    max_occurrence = 0        # 대입 연산 1번 실행
    max_alphabet_index = 0    # 대입 연산 1번 실행
    for index in range(len(alphabet_occurrence_list)):    # alphabet_array 의 길이(26)만큼 아래 연산이 실행
        alphabet_occurrence = alphabet_occurrence_list[index] # 대입 연산 1번 실행
        if alphabet_occurrence > max_occurrence: # 비교 연산 1번 실행
            max_occurrence = alphabet_occurrence # 대입 연산 1번 실행
            max_alphabet_index = index           # 대입 연산 1번 실행
둘을 비교해보면
첫 번째 방법은 52N+104, 두 번째 방법은 3N + 106 이라는 식이 나온다는 걸 알 수 있습니다. 그러면 N 의 길이가 길어질수록, 다음과 같이 연산량이 변화합니다. 비교를 위해서 N^2 도 추가해서 비교했습니다.

- 52N + 104 든 3N+106 이든 N^2 에 비해서 아무것도 아니다.
- 공간 복잡도보다는 시간 복잡도를 더 신경 써야 한다.
공간복잡도
입력값과 문제를 해결하는 데 걸리는 공간과의 상관관계.시간복잡도와 유사하다.
이 계산으로 나오는 값은 모두 상수이므로 크던 작던 상관이 없다.
대부분의 문제에서는 알고리즘의 성능이 공간에 의해서 결정되지 않습니다. 따라서 공간 복잡도보다는 시간 복잡도를 더 신경 써야한다.
위의 최빈값을 구하는 방법의 첫번째 방법예시로
1. alphabet_array 의 길이 = 26
2. arr_index, max_occurrence, max_alphabet_index, alphabet_occurrence 변수 = 4 = 30
		alphabet_occurrence_list = [0] * 26 # -> 26 개의 공간을 사용합니다

    for char in string:
        if not char.isalpha():
            continue
        arr_index = ord(char) - ord('a')  # 1개의 공간을 사용합니다
        alphabet_occurrence_list[arr_index] += 1

    max_occurrence = 0                   # 1개의 공간을 사용합니다
    max_alphabet_index = 0               # 1개의 공간을 사용합니다
    for index in range(26):
        alphabet_occurrence = alphabet_occurrence_list[index] # 1개의 공간을 사용합니다
        if alphabet_occurrence > max_occurrence:
            max_occurrence = alphabet_occurrence
            max_alphabet_index = index
위의 최빈값을 구하는 방법의 두번째 방법예시로
저장하는 데이터 양이 1개의 공간으로 사용한다.
1.alphabet_array 의 길이 = 26
2.max_occurrence, max_alphabet, occurrence 변수 = 3 = 29
    alphabet_array = ["a", "b", "c", "d", "e", "f", "g", "h", "i", "j", "k", "l", "m", "n", "o", "p", "q", "r", "s", "t", "u", "v", "x", "y", "z"]
# -> 26 개의 공간을 사용합니다
    max_occurrence = 0 # 1개의 공간을 사용합니다
    max_alphabet = alphabet_array[0]   # 1개의 공간을 사용합니다.

    for alphabet in alphabet_array:
        occurrence = 0  # 1개의 공간을 사용합니다
점근표기법
알고리즘의 성능을 수학적으로 표기하는 방법.
알고리즘의 “효율성”을 평가하는 방법.지금까지 이 함수는 N 정도의 시간과 공간이 걸리겠구나 하면서 분석했던 게 점근 표기법의 일종이라고 할 수 있다.
점근 표기법의 종류에는 빅오(Big-O)표기법, 빅 오메가(Big-Ω) 표기법이 있습니다
빅오 표기법은 최악의 성능이 나올 때 어느 정도의 연산량이 걸릴것인지,
빅오메가 표기법은 최선의 성능이 나올 때 어느 정도의 연산량이 걸릴것인지에 대해 표기합니다.
빅오 표기법으로 표시하면 O(N), 빅 오메가 표기법으로 표시하면 Ω(1) 의 시간복잡도를 가진 알고리즘이라고 표현한다.
def is_number_exist(number, array):
    for element in array: # array의 길이만큼 아래 연산이 실행
        if number == element: #비교연산 실행
            return True # N X 1 = 만큼의 시작복잡도가 걸렸다.
    return False
위에서 연산된 것들을 더해보면, 이렇게 총 N * 1의 시간 복잡도를 가진다는 걸 볼 수 있습니다.
input = [4, 5, 6, 1, 2, 3] 이라는 입력값에 대해서 3을 찾으면 어떻게 될까요? 마지막 원소 끝까지 찾다가 겨우 마지막에 3을 찾아 결괏값을 반환하게 됩니다. 즉, 운이 좋지 않으면 input의 길이(N) 만큼 연산 이후에 답을 찾을 수 있습니다.
알고리즘의 성능은 항상 동일한 게 아니라 입력값에 따라서 달라질 수 있습니다. 어떤 값을 가지고 있는지, 어떤 패턴을 이루는 데이터인지에 따라서 뭐가 좋은 알고리즘인지 달라질 수 있다는 의미이다.
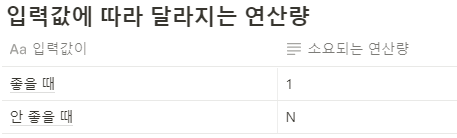
빅오 표기법으로 표시하면 O(N), 최악일 때 N만큼의 연산량이 걸린다.
빅 오메가 표기법으로 표시하면 Ω(1) 의 시간복잡도를 가진 알고리즘이다.
대부분의 입력값은 최선일 경우가 거의 없다. 항상 최악의 경우를 대비해야하기 때문에 빅오 표기법으로 표기한다.
※기억하자!!
1. 입력값에 비례해서 얼마나 늘어날지 파악해보자. 1 ? N ? N^2 ?
2. 공간복잡도 보다는 시간 복잡도를 더 줄이기 위해 고민하자.
3. 최악의 경우에 시간이 얼마나 소요될지(빅오 표기법)에 대해 고민하자
#마치며
아직..알고리즘을 이해 못했다ㅠㅠ....뭔가A=B다라는 형식이 아닌 A는B일수도있고,C일수도있지만 편한대로 하는게 좋을거야...이런식의 해답이니 좀 생각할 게 많아지는 느낌..내일 다시 공부해야겠다..
'[내일배움캠프] > TIL' 카테고리의 다른 글
| 22.11.11)알고리즘과 CS를배운 10일차 (0) | 2022.11.11 |
|---|---|
| 22.11.10)Client와 알고리즘을 배운9일차 (1) | 2022.11.10 |
| 22.11.08)python의 기초에 대해 배운 7일차 (0) | 2022.11.08 |
| 22.11.07)JS의 첫날인 6일차 (1) | 2022.11.07 |
| 22.11.04)드디어 미니프로젝트의 끝인 5일차 (0) | 2022.11.04 |


