#오늘 배운 것
GET/POST
서비스(서버)가 돌아가는 원리(Get,POST) = 요청(requests) 제공 (response)
요청은 url로 전달한다. 브라우저는 요청하기 위한 도구.
버튼을 누르면 버튼 안 url을 요청하고 서버는 매핑하는 url을 제공(render)한다.
toast방식으로 아이디/패스워드를 url을 서버에 보내게된다. > 서버에 맞는 정보를 찾아 브라우저에 보낸다.(rendering도 같이 제공)
venv (가상 컴퓨터) : 가상환경에 따라 컴퓨터 세팅이 다를수 있으니 사용.
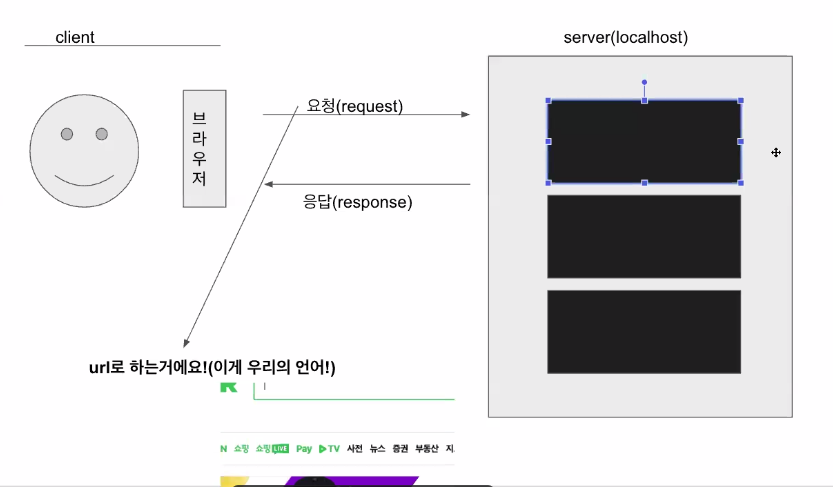
내 컴퓨터를 지정할 때 로컬호스트로 지정한다. ip 127.0.0.1
로컬호스트로 지정한 서버 중 여러가지 프로그램 중 하나가 app.py
프레임워크 : 개발에 집중할 수 있도록 도와준다.
@app.route('/') : 어디로 가야할지 정해주는 것.(경로)
포트:5000 - 모든걸 다 막고 일부만 노출시키는 것.나라의 항구라 비유하면 편하다. 항구의 이름을 구분하기 위한 번호.
서버-클라이언트에게 템플릿을 준다.
return reder_template('index.html) > index라고 적힌 html을 reder_template을 통해 서버에 return한다.
log 는 컴퓨터에 발생하는 모든 일을 적는다.
clear - 로그를 깔끔하게 ,ls - 폴더 안 파일 확인, pwd - 현재 경로를 알려줌, cd - change directoy 현재경로에 상위,하위폴더로 옮길 수 있다.
axios- 비동기 호출로 추후 프로젝트에 사용한다고 함.
methods에 post를 따로 적지 않으면 get이다. (기본 get)
a.jax라는 서버를 호출할 때(url을 대신해서 친다고 생각하면 된다.)
get : 파라미터 노출 ex)12.7.0.0.1:5000 id='',pwd"" (get방식의 경우 노출되기 때문에 post사용)/때문에 렌더링용으로만 사용한다.
post : 파라미터 노출X
파라미터 : id ,pwd를 서버로 요청할때 그 값을 가지고 이동하는 것.(매개변수)
ex) data : {key : 'value' }
비동기호출 :
동기처리의 경우 3가지 요청을 할때는 순서대로 하는거지만
비동기의 경우 한번에 기다리지않고 처리한다.
끊기지않고 한번에 일어나는것.
skeleton ui : 서버로부터 어떤방식을 요청했을 때 이미 ui뼈대를 그려놔서 실행된것처럼 보이도록 만든것.
다른분이 말씀하신 궁금증
app.py를 실행했을 때, Running on http://127.0.0.1:5000 은 왜 뜨는지 알겠어!
그렇다면 그 아래에 떠있는 주소 는 뭐지?
바로 인터넷 연결 주소인 것 같습니다!
192.~.~.~ 은 나의 컴퓨터(클라이언트) -> 인터넷(브라우저) -> 나의 컴퓨터(서버) 라는 여정을 통해!!
인터넷을 들어갈 때 받은 나의 인터넷 ip 주소 인 것 같습니다.
이는 인터넷에 "내 아이피" 를 치거나,
"윈도우 설정 -> 네트워크 및 인터넷 -> 이더넷(Wi-Fi) 속성 -> 아래쪽 속성 부분의 IPv4" 부분을 보셔서 확인 할 수 있습니다.
혹은! " 윈도우 + R " 을 눌러 실행창을 킵니다 -> cmd 를 적고 확인 -> 명령프롬프트가 뜨면 ipconfig 입력 후 엔터! -> 그럼 본인이 사용하고 있는 네트워크 목록이 나오는데 거기서 IPv4 주소를 확인 할 수도 있습니다!조금 더 설명을 추가하면, 루프백 IP주소는 "현재 내가 사용하고 있는 장치 자체의 주소" 로 생각하면 될 것 같습니다.
즉, 나 자신 을 가리키는 IP라고 생각됩니다.
우리의 app.py 에 마지막 코드는 다들 app.run('0.0.0.0', port=5000, debug=True) 로 되어있으리라 생각됩니다.
이 때, 0.0.0.0 은 local 장치의 모든 IP를 뜻한다고 합니다.
"브라우저로 서버에 접속할 때의 url"의 역할인 듯 합니다.제가 위에서 나의 컴퓨터(클라이언트) -> 인터넷(브라우저) -> 나의 컴퓨터(서버) 라는 여정을 통해 나의 인터넷 ip주소 를 받게 된다고 했는데, 0.0.0.0 에 나의 인터넷 ip 주소를 넣어도 잘 작동하는 것을 알 수 있습니다.
(단, 이때는 localhost:5000 이 아닌 " 나의 인터넷 ip 주소:5000 " 을 통해 브라우저로 서버에 접속이 가능합니다)
나중을 위해 복사붙여넣기 해놓았다!
알고리즘
소수는 자기자신과 1외에는 아무것도 나눌수 없다.
파이썬의 range = js의 for(여기) : range(10)을 하면 [0,1,2 ~~ 9] 이렇게 반환한다.
for (let i = 0; i < 10, i++) {}
아스키 코드를 chr로 변환한 것이다.
2n+1은 2n이나 다름없다. +1은 상수이기 때문이다.
상수가 크면 클수록 성능 차이가 많이 난다.
특정 자료구조는 삽입/삭제가 빠르고 특정 자료구조는 조회가 빠르다.
이처럼 어떤 경우에는 이 자료구조가 좋고, 어떤 경우에는 저 자료구조가 좋은 것 처럼 경우에 따라 다양한 자료구조와 알고리즘을 사용한다.
자료구조쓸때 선택 고려해야할것
삽입시간,삭제시간,검색시간,정렬여부
배열(array) : 순차적으로 데이터를 저장하는 공간.크기가 정해진 데이터의 공간이다.
- 배열을 모르면 인덱스에 접근할 수 없다.(ex:캡슐호텔)
- 배열은 각 원소에 즉시 접근할 수 있습니다 .여기서, 원소의 순서는 0부터 시작하고 이를 인덱스라고 부릅니다.
- 이 때, 즉시 접근 가능하다는 말은 상수 시간 내에 접근할 수 있음을 의미합니다. 즉, O(1) 내에 접근할 수 있다고 말하곤 합니다.
- 배열은 원소를 중간에 삽입/삭제 하려면 모든 원소를 다 옮겨야한다.배열의 길이 N 만큼을 옮겨야 하므로 O(N)의 시간 복잡도를 가진다.
- 원소를 새로 추가하려면, 새로운 공간을 할당해야 하므로 매우 비효율적인 자료구조이다.
링크드리스트 : 다음 node라고 불리는 공간에 데이터를 저장하고 그 다음공간을 지목하는 포인터로 연결.
- 리스트는 크기가 정해지지 않은 데이터의 공간이다.
- 리스트는 특정 원소에 접근하려면 연결 고리를 따라 탐색해야 합니다. 최악의 경우에는 모든 화물 칸을 탐색해야 하므로 O(N)의 시간 복잡도를 가진다.
- 링크드리스트는 각 칸마다 연결되어있다. 이런식으로 사용하는 이유는 삽입과 삭제에 용이하다.(ex:화물칸)
- 추가할 것에 선을 연결하여 앞뒤어 포인터만 변경하면 추가/삭제 할 수 있다.대신 컨스턴트하게 접근할 수 없다.
- 접근하려면 맨 처음의 헤드로 들어가야한다. 한방향으로밖에 접근할 수 없다.
- 백워드 트러블스하지않는 이상 못한다.
- 더블 링크드 리스트를 하면 좋다.
- 서로가 쌍방으로 선이 연결되어있어 왔다갔다 할 수 있다.
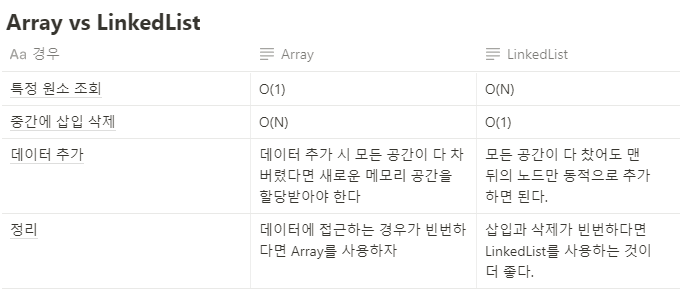
※파이썬의 list는 array로 칭한다.
클래스
분류. 집합. 같은 속성과 기능을 가진 객체
class Person:
    def __init__(self, param_name):
				print("hihihi", self)
        self.name = param_name

    def talk(self):
        print("안녕하세요 저는", self.name, "입니다")

person_1 = Person("A") # <__main__.Person object at 0x1090c76d0> : person클래스의 객체가 생성됨.
# 다만 이 객체를 주소값으로 분류하였다.
print(person_1)

person_2 = Person("B")
print(person_2)  # <__main__.Person object at 0x1034354f0>

#person이라고 하는 생성자()를 통해 param_name이 클래스의 self.name에 저장되어 호출한 것이다.- person은 객체.소괄호는 생성자.즉, 객체를 생성하는 함수를 의미한다.
- 클래스를 만들 때 생성자를 설정하기 위해서는 > __init__<
- def__init하면 자동으로 완성된다.
- self는 생성할때 인자에 자기자신으로 가리킨다.
- self.name 에 param_name 을 저장해두겠다는 건 그 객체의 name 이라는 변수에 저장된다는 의미
- 클래스 내부의 함수는 메소드 라고 함.
링크드 리스트
1) 노드 안 데이터
2) 다음 데이터가 무엇인지
>클래스를 사용하여 묶으면 편하다!
클래스의 생성자에 data 를 인자로 받아서 self.data 에 받는다.(저장)
※참고로__init__에 있는 data는 파라미터고, self.data의 data는 클래스 내부에서 사용되는 저장되는 변수다.
현재는 다음 이어진 노드가 없기 때문에 self.next 에는 None 을 넣어둔다.
class Node:
    def __init__(self, data):
        self.data = data
        self.next = None

# 3을 가진 Node 를 만드려면 아래와 같이 하면 됩니다!
node = Node(3) # 현재는 next 가 없이 하나의 노드만 있습니다. [3]
first_node = Node(5) # 현재는 next 가 없이 하나의 노드만 있습니다. [5]
second_node = Node(12) # [12] 를 들고 있는 노드를 만듭니다.
first_node.next = second_node # 그리고, [5]의 next 를 [12]로 지정합니다. [5] -> [12]노드를 일일이 계속 연결한다면 변수를 지정하고 위같은 코드를 반복해야하기 때문에 매우 번거롭다.
그래서 LinkedList 라는 클래스를 사용하면 편하다. LinkedList 는 head node 만 가지고 있다.
기차로 표현한다면 기차의 맨 앞칸에만 정보를 저장하는 것이다 > 다음칸으로 가려면 next를 통해 노드를 접근한다.
1) LinkdList 는 self.head 에 시작하는 노드를 저장한다.
2) 다음 노드를 보기 위해서는 각 노드의 next 를 조회해서 찾아가야 한다
링크드리스트의 추가와 전체출력
class Node:
    def __init__(self, data):
        self.data = data
        self.next = None

#headnode만 있으면 된다.
class LinkedList:
	#해당 data를 들고있는 노드를 적는다.그럼 headnode로 저장이 된다.
	#3을 저장한 node를 저장했다.
	#.next로 출력하면 none이 된다. node의 .next를 none으로 표기했기 때문
    def __init__(self, value):
        self.head = Node(value)
 #append를 활용해서 뒤에 data가 노드로 생성되 붙도록함.
    def append(self, value):
	#맨뒤의 노드까지 이동해야한다.
	#head가 none일 상태일 경우 none의 next가 없으니 에러가 날 수 있다.
        cur = self.head
        while cur.next is not None:
            cur = cur.next
        cur.next = Node(value)
        #cur을 사용해서 맨끝의 노드로 이동한다.while문을 사용해 next가 none이 될때까지 돌리면 된다.
        #탐색하는 노드를 변수에 담아서 저장한다.

   #모든 노드의 값을 출력하기
   #노드를 따라가면서 값을 출력한다.
   #head에 저장되어있는 노드를 cur 라는 변수에 담고,
    #cur 의 data를 출력
    def print_all(self):
        cur = self.head
        while cur is not None:
            print(cur.data)
            cur = cur.next
#cur이라는 변수가 headnode에 있다 > 현재 노드가 다음노드로 이동하고 None전 까지 cur변수를 출력한다.
linked_list = LinkedList(5)
linked_list.append(12)
linked_list.print_all()
링크드리스트 원소 찾기
class Node:
    def __init__(self, data):
        self.data = data
        self.next = None


class LinkedList:
    def __init__(self, value):
        self.head = Node(value)

    def append(self, value):
        cur = self.head
        while cur.next is not None:
            cur = cur.next
        cur.next = Node(value)

    def print_all(self):
        cur = self.head
        while cur is not None:
            print(cur.data)
            cur = cur.next
    #next_node로 가는것을 index번해야한다.
    #head에 저장되어있는 노드를 node 라는 변수에 담고,
    #count 라는 인덱스를 저장하기 위한 변수를 저장
    #그리고 count 가 index 가 될 때까지  (이 때, while 문 내부에서 1씩 더해주니까 작을때까지로 조건을 넣습니다)
    #node의 next 값을 node 에 대입하고 count 를 증가합니다.
    #이 과정을 count 가 index가 아닐때까지 반복 후 node 를 반환
    def get_node(self, index):
        node = self.head
        count = 0
        while count < index:
            node = node.next
            count += 1
        return node

   # 따라서 next_node 라는 변수에 현재 노드와 연결된 노드를 저장해두고,
    # 1. 현재 노드의 다음 노드를 새로운 노드와 연결합니다.
    # 2. 새로운 노드의 다음 노드를 이전에 저장해둔 노드에 연결합니다.
    def add_node(self,index,value):
        #클래스내부의 함수를 부르기 위해서는 self.함수이름
        new_node = Node(value) #[6]
        #-1이라는 코드가 있으면 예외처리를 해야한다.
        #새로운 노드의 next 를 현재 가지고 있는 head 에 연결하고,
        #우선 현재 가지고 있는 head 를 새로운 노드로 교체한다.
        #self.headnode를 new_node로 하면 안된다. 이전에 했던 headnode들이 사라진다.
        if index == 0:
            new_node.next = self.head #[6] > [5]
            self.head = new_node #head에 6을 지정해준다.
            return

        node = self.get_node(index -1) #[5]
        next_node = node.next #[12]
        node.next = new_node #[5] > [6]
        new_node.next = next_node #[6] > [12]
        return
링크드리스트 원소 삭제
    def delete_node(self, index):
        #if-index가 0이라면? 그에 대한 핸들링을 처리해야한다.추가와같이 예외처리한다.
        #head에 head.next를 대입하면 된다.
        if index == 0:
            self.head = self.head.next
            return
        node = self.get_node(index - 1)
        node.next = node.next.next
'[내일배움캠프] > TIL' 카테고리의 다른 글
| 22.11.14)알고리즘을 심화학습한 11일차 (1) | 2022.11.14 |
|---|---|
| 22.11.11)알고리즘과 CS를배운 10일차 (0) | 2022.11.11 |
| 22.11.09)알고리즘을 배운 8일차 (1) | 2022.11.09 |
| 22.11.08)python의 기초에 대해 배운 7일차 (0) | 2022.11.08 |
| 22.11.07)JS의 첫날인 6일차 (1) | 2022.11.07 |


