#오늘배운 것
정렬 - 데이터를 순서대로 나열하는 방법 .이진 탐색을 가능 및데이터를 좀 더 효율적으로 탐색할 수 있게 한다.
버블정렬 : 첫 번째 자료와 두 번째 자료를, 두 번째 자료와 세 번째 자료를, 세 번째와 네 번째를, … 이런 식으로 (마지막-1)번째 자료와 마지막 자료를 비교하여 교환하면서 자료를 정렬하는 방식.
원소와 원소를 교환한다고 생각하면 된다.gif를 보면 좀 더 쉽게 이해할 수 있다.
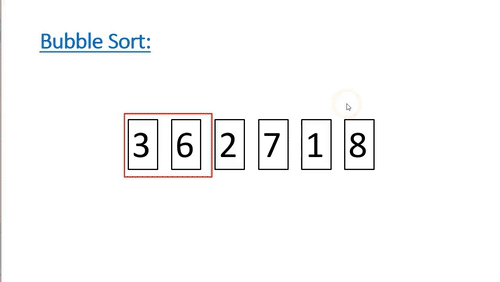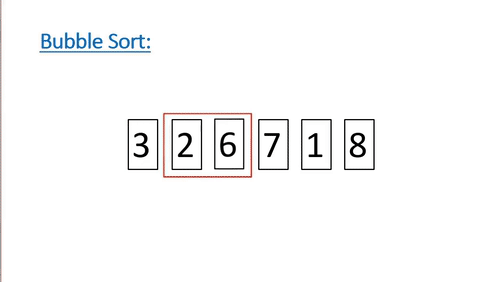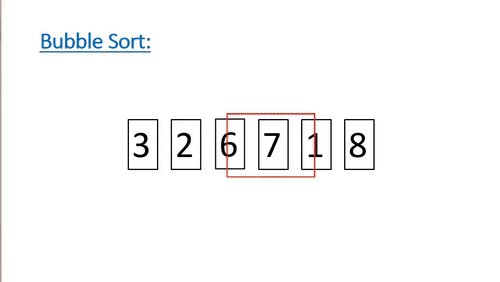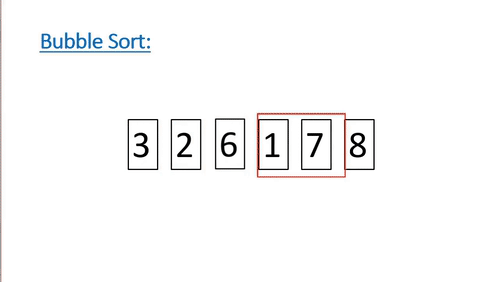
※swap하는 방법
a, b = b, a
>>> a = 3
>>> b = 4
>>> a, b = b, a
>>> print(a)
4
>>> print(b)
3
선택정렬 - 말 그대로 선택해서 정렬한다. 전체적으로 훑어보고 작은숫자와 앞에 있는 숫자를 교체하는 방식.
버블 정렬보다 훨씬 더 적은 비교를 하는 것 같지만, 실제로는 각 배열을 계속해서 탐색하는 방식이라 2중 반복문을 사용해야 한다.
선택정렬 예시
input = [4, 6, 2, 9, 1]

#배열의 크기만큼 반복했다가 앞에서부터 한개씩 줄어들면서 반복하는 구조.
def selection_sort(array):
    n = len(array)
    #최솟값을 찾아 변경하기 때문에 인덱스변수를 하나 생성
    for i in range(n - 1): #맨 마지막에 남은 원소는 비교하지 않는다. 그래서 전체길이만큼 반복X
        min_ind = i
        for j in range(n - i): #하나씩 줄어드는 방식
            if array[i + j] < array[min_ind]:
                min_ind = i + j
        #내부 반복문이 끝나면 i와 min_ind교체한다.
        array[i], array[min_ind] = array[min_ind],  array[i]
    return
    #시간복잡도 : 반복문을 2번 썼기 때문에 O[N^2]만큼 걸린다.

selection_sort(input)
print(input) # [1, 2, 4, 6, 9] 가 되어야 합니다!
삽입 정렬 - 선택 정렬이 전체에서 최솟값을 "선택" 하는 거 였다면, 삽입 정렬은 전체에서 하나씩 올바른 위치에 "삽입" 하는 방식이다. 선택 정렬은 현재 데이터의 상태와 상관없이 항상 비교하고 위치를 바꾸지만, 삽입 정렬은 필요할 때만 위치를 변경하므로 더 효율적인 방식이다.
시간복잡도 : 선택정렬과 버블정렬은 반복문을 2번 썼기 때문에 O[N^2]만큼 걸린다.
삽입정렬의 경우 break문이 있으면 안의 반복문은 멈추게 되므로 N의 시간이 걸리는 것이다.
병합 정렬 - 배열의 앞부분과 뒷부분의 두 그룹으로 나누어 각각 정렬한 후 병합하는 작업을 반복하는 알고리즘
예를 들어서 A 라고 하는 배열이 1, 2, 3, 5 로 정렬되어 있고, B 라고 하는 배열이 4, 6, 7, 8 로 정렬되어 있다면 이 두 집합을 합쳐가면서 정렬하는 방법입니다. = 두집합을 합쳐서 숫자대로 정렬한다. 만약 A배열의 숫자가 끝날 경우 하나씩 C에 추가해준다.
정렬방법
array_a = [1, 2, 3, 5]
array_b = [4, 6, 7, 8]


def merge(array1, array2):
    array_c = []
    #인덱스를 저장한 변수
    array1_index = 0
    array2_index = 0
    #array1_index가 끝나기 전까지~array길이보다 작을 때
    while array1_index < len(array1) and array2_index < len(array2):
        if array1[array1_index] < array2[array2_index]:
            array_c.append(array1[array1_index])
            array1_index+=1
        else:
            array_c.append(array2[array2_index])
            array2_index+=1
    #남은 코드들을 한꺼번에 넣어주는 코드
    if array1_index == len(array1):
        while array2_index < len(array2):
            array_c.append(array2[array2_index])
            array2_index += 1
    if array2_index == len(array2):
        while array1_index < len(array1):
            array_c.append(array1[array1_index])
            array1_index += 1
    return array_c
#1. 두 개의 배열을 합치기 위해서는 각 배열의 값들을 하나씩 비교
#2. 더 작은 값을 새로운 배열에 하나씩 추가해갑니다.
#3. 그 후 한 배열이 끝난다면 남은 배열의 모든 값을 새로운 배열에 추가.
# >result 라는 새로운 배열을 만든 다음 while 문을 이용해서 비교 이후에 값을 추가

print(merge(array_a, array_b)
병합정렬 - 분할정복의 개념을 적용한다.
분할정복 :
문제를 작은 2개의 문제로 분리하고 각각을 해결한 다음, 결과를 모아서 원래의 문제를 해결한다. 리스트의 원소들을 각각 분할해서 합칠 때 정렬시킨다고 생각하면 된다.(merge함수로 array 인덱스를 따라가 정렬한다)
재귀함수형식으로 정의해 본다면 [MergeSort(시작점, 끝점)]
따로 탈출 조건이 필요하다.ex) 문자열의 길이가 1보다 작거나 같을 때
                  #1,2,3,5                  #4,6,7,8
MergeSort(0, N) = Merge(MergeSort(0, N/2) + MergeSort(N/2, N))
#merge의 반 반이 합쳐지면서 정렬되는 병합과정을 한다면 재귀함수형식으로 될수잇다.
#0부터 N까지 정렬한 걸 보기 위해서는
0부터 N/2 까지 정렬한 것과 N/2부터 N까지 정렬한 걸 합치면 된다.
#예시
def merge_sort(array):
if len(array) <= 1:
return array
mid = (0 + len(array)) // 2
left_array = merge_sort(array[:mid]) # 왼쪽 부분을 정렬하고
right_array = merge_sort(array[mid:]) # 오른쪽 부분을 정렬한 다음에
merge(left_array, right_array) # 합치면서 정렬하면 됩니다!merge함수의 경우 arr1,arr2를 다 볼때까지가 반복의 기준이다.그래서 arr1와 arr2만큼 시간복잡도가 걸린다.
arr1,arr2,는 결국 arr를 반으로 쪼갠것이기 때문에 N(0)을 시간을 가진다.
margesort함수의 경우 arr가 N이라고 가정했을 때 각각 쪼갠 것을 N/2 2개를 비교하면서 합친다.
그래서 N/2 * 2로 계산해 N만큼 걸린다. 탈출조건을 봤을 떄 K단계를 거치면 N의 길이가반씩 쪼개지면서 1이된다.
이것을 수식으로 나타내면 N/^2K = 1 > K = log2N이다
즉 K단계만큼 반복하는데 각 단계는 0(N)의 시간복잡도를 가진다. log2N * 0(N) > 0(NlogN)
스택 - 한쪽 끝으로만 자료를 넣고 뺄 수 있는 자료 구조
last In First Out( LIFO) :늦게들어간 자료가 빨리나오고 먼저들어간 자료가 늦게나온다.
컴퓨터의 ctrl+z 되돌리기를 생각하면 된다.
스택 자료구조 메소드들 :
push(data) : 맨 앞에 데이터 넣기
data라는 인자를 받는다.
pop() : 맨 앞의 데이터 뽑기
인자가 없는 이유: 맨위의 데이터만 뽑기 떄문
peek() : 맨 앞의 데이터 보기
isEmpty(): 스택이 비었는지 안 비었는지 여부 반환해주기
class Node:
    def __init__(self, data):
        self.data = data
        self.next = None


class Stack:
    def __init__(self):
        self.head = None

    def push(self, value):                 # 현재 [4] 밖에 없다면
        new_head = Node(value)             # [3] 을 만들고!
        new_head.next = self.head          # [3] -> [4] 로 만든다음에
        self.head = new_head               # 현재 head의 값을 [3] 으로 바꿔준다.

    # pop 기능 구현
    def pop(self):
        if self.is_empty():                  # 만약 비어있다면 에러!
            return "Stack is empty!"
        delete_head = self.head              # 제거할 node 를 변수에 잡습니다.
        self.head = self.head.next           # 그리고 head 를 현재 head 의 다음 걸로 잡으면 됩니다.
        return delete_head                   # 그리고 제거할 node 반환

    def peek(self):
        if self.is_empty():
            return "stack is empty"
        return self.head.data

    # isEmpty 기능 구현
    def is_empty(self):
        return self.head is None
※스택 실전 사용법 : 실제 코드에서는 파이썬의 list 를 이용해서 스택으로 사용
스택을 빈 리스트에 넣어주면 append함수로 데이터을 쌓고 top으로 pop처럼 맨 위 데이터를 꺼낸다.
range(a,b,c) a = range(시작하는 점, 끝나는 점, 연산을 하나씩 줄여갈 건가)
스택의 경우 링크드리스트로 유사하게 구현이 가능하다.
스택큐 - 들어가고 나오는 곳이 정해져있는 자료구조
큐 - 한쪽 끝으로 자료를 넣고, 반대쪽에서는 자료를 뺄 수 있는 선형구조.
데이터를 한쪽 끝으로 넣고, 반대쪽에서 빠져 나온다.
First In First Out (FIFO): 가장 처음에 들어간 데이터는 빨리 나오고, 가장 마지막에 들어간 데이터는 가장 늦게 나온다.
순서대로 처리되어야 하는 일에 필요하다.데이터 넣고 뽑는 걸 자주하는 자료 구조로 구현한다.
스택과 마찬가지로 링크드리스트 형식으로 구현한다.
다만 큐는 끝과 시작의 노드를 전부 가지고 있어야 하므로 self.head 와 self.tail 을 가진다.
자료구조 메소드
enqueue(data) : 맨 뒤에 데이터 추가하기
dequeue() : 맨 앞의 데이터 뽑기(빠지는건 맨앞에서 빠지는 넣는건 맨 뒤에서 넣는다)
peek() : 맨 앞의 데이터 보기
isEmpty() : 큐가 비었는지 안 비었는지 여부 반환해주기
예시
class Node:
    def __init__(self, data):
        self.data = data
        self.next = None


class Queue:
    def __init__(self):
        self.head = None
        self.tail = None

    def enqueue(self, value):
        #아무것도 넣지 않았다면 None이 tail이자 head이니 오류가 발생한다.
        # #if문으로 처리한다.
        if self.is_empty():
            self.head = new_node  # head 에 new_node를
            self.tail = new_node  # tail 에 new_node를 넣어준다.
            return
        new_node = Node(self, value)
        self.tail.next = new_node
        self.tail = new_node
        return

    def dequeue(self):
        if self.is_empty():
            return "Queue is empty!"
        delete_head = self.head  # 제거할 node 를 변수에 잡습니다.
        self.head = self.head.next # 그리고 head 를 현재 head 의 다음 걸로 잡으면 됩니다.
        return delete_head.data

    def peek(self):
        if self.is_empty():
            return "Queue is empty!"
        return self.head.data

    def is_empty(self):
        return self.list.head is None
해쉬테이블 - 데이터의 검색과 저장이 아주 빠르게 진행된다. 딕셔너리를 해쉬 테이블이라고 부르기도 한다.
해쉬 - 알고리즘을 통해 문자열을 고정된 길이의 데이터로 만든다.효율적인 자료구조인 딕셔너리를 만들때 사용
딕셔너리는 내부적으로는 배열을 사용한다.딕셔너리 내부의 배열이란 저장소에서 빠른과 느린이 저장되어 있는데 그 인덱스를 어떻게 찾아야할까? = 해쉬함수를 이용한다.
해쉬 함수 : 임의의 길이를 갖는 메시지를 입력하여 고정된 길이의 해쉬값을 출력하는 함수.파이썬에서 제공하고있다.
계산하는 법 :배열의 길이로 나눈 나머지 값 - hash(key) % len(self.items)
dict = {"fast" : "빠른", "slow": "느린"}

>>items[hash("fast") % 8] = "빠른"
형식으로 인덱스를 저장등록하는 것도 있다.
시간복잡도의 경우 상수만큼 계산속도가 난다. 0(1)!

>>items[hash("fast") % 8] = 데이터를 찾아서 출력한다.
class Dict:
def __init__(self):
self.items = [None] * 8
#put = 딕셔너리에 새로운 key와 value를 추가해준다.
def put(self, key, value):
index = hash(key) % len(self.items)
self.items[index] = value
return
def get(self, key):
index = hash(key) % len(self.items)
self.items= index
return
#임의의 문자열이 해쉬 함수에 나오더라도 인덱스값이 동일해질 때가 있다.
#인덱스 값이 같으면 똑같은 배열 위치에 value값을 업데이트 시켜 이전 값을 덮어 씌워버릴 수도 있다.
#해결방법 1. 링크드리스트 사용. 테스트를 추가함으로써 노드로 이어준다.
# 다만 키값도 같이 저장해줘야함. 추후에 찾을 때 어떤 키를 저장했는지 알아야 한다.수정방법
class LinkedTuple:
    def __init__(self):
        self.items = [None] * 8
    #add는 키와 값을 동시에 받음.각각의 튜플을 추가하는 방식.
    def add(self, key, value):
        self.items.append((key,value)) #새로운 튜플 추가
    #튜플 내 값을 찾기위해 get추가
    def get(self, key):
        for k, v in self.items:
            if key == k:
                return v

class LinkedDict:
    def __init__(self):
        self.items = [] # 안에 LinkedTuple()이 반복되고 있다.
        for i in range(8):
            self.items.append(LinkedTuple())

    def put(self, key, value):
        #키를 가지고 인덱스를 찾아야 한다.
        index = hash(key) % len(self.items)
        #LinkedTuple()이 빈값에 들어가 있으니 새로운 키와 값을 추가하면 된다,
        self.items[index].add(key,value)
        return

    def get(self, key):
        index = hash(key) % len(self.items)
        self.items[index].get(key)
        return
#체이닝방식이다. 각 배열마다 링크드리스트를 연결해 놓은 방식이다.
#그리고 키가 동일하다면 아이템 뒤 아이템으로 만들어놓고,
# 키가 도달한다면 그 키에대한 링크드 리스트를 조회해서 값으로 반환해준다.

#해결방법 2. 개방주소법 : 배열의 다음 남는 공간에 값을 넣는 것이다.
'[내일배움캠프] > TIL' 카테고리의 다른 글
| 22.11.16)SPA와 DB를 배운 13일차 (1) | 2022.11.16 |
|---|---|
| 22.11.15)알고리즘을 배운 12일차. (1) | 2022.11.15 |
| 22.11.11)알고리즘과 CS를배운 10일차 (0) | 2022.11.11 |
| 22.11.10)Client와 알고리즘을 배운9일차 (1) | 2022.11.10 |
| 22.11.09)알고리즘을 배운 8일차 (1) | 2022.11.09 |

